کدوم مدل هوش مصنوعی واقعاً بهتره؟
همه مدلها از یه آزمون ثابت فارسی رد میشن: ۲۰ سؤال کارنامه و ۸ ساخت تعاملی، از بازی و سنتور تا تقویم شمسی و برج آزادی سهبعدی. نمره رو کد، یه مرورگر خودکار و یه هیئت داوری سهنفره میدن. ساختهها رو همینجا خودتون امتحان کنید.
01قهرمان فعلی
02ردهبندی
نمره هر مدل میانگین اجراهاشه (مدلی که هنوز یه اجرا داره «موقت»ه) · هزینه = پولی که خود مدل برای کل آزمون گرفت، بدون داوری| # | مدل | رتبه | نمره MRMP | کارنامه | ویترین | نظر محسن | هزینه جوابها | سرعت |
|---|---|---|---|---|---|---|---|---|
| 01 | Anthropic: Claude Opus 5.5 anthropic/claude-opus-5.5 | S | ۹۸٫۵۹ بین ۹۷٫۱۷ و ۱۰۰ | ۳۹ / ۴۰ | ۵۹٫۵۹ / ۶۰ | – | ۱٬۳۸۱٬۶۰۰ تومان ۵٫۱۲ دلار | ۱۳۷ توکن/ث |
| 02 | OpenAI: GPT-6.1 Sol openai/gpt-6.1-sol | S | ۹۴٫۴۲ بین ۹۲٫۷۱ و ۹۶٫۱۳ | ۳۸ / ۴۰ | ۵۶٫۴۲ / ۶۰ | – | ۲۷۲٬۳۰۰ تومان ۱٫۰۱ دلار | ۵۹ توکن/ث |
| 03 | SpaceXAI: Grok 4.7 x-ai/grok-4.7 | S | ۹۴٫۱۳موقت | ۳۶ / ۴۰ | ۵۸٫۱۳ / ۶۰ | – | ۹۱۶٬۶۰۰ تومان ۳٫۴۰ دلار | ۱۳۴ توکن/ث |
| 04 | Google: Gemini 3.8 Flash google/gemini-3.8-flash | S | ۹۳٫۰۳ بین ۹۲٫۸۳ و ۹۳٫۲۳ | ۳۶ / ۴۰ | ۵۷٫۰۳ / ۶۰ | – | ۲۰۱٬۹۰۰ تومان ۷۴٫۸ سنت | ۱۷۹ توکن/ث |
| 05 | Google: Gemini 4 Argon google/gemini-4-argon | S | ۹۰٫۸۵ بین ۸۹٫۲۳ و ۹۲٫۴۶ | ۳۳ / ۴۰ | ۵۷٫۸۵ / ۶۰ | – | ۳۵۹٬۶۰۰ تومان ۱٫۳۳ دلار | ۸۵ توکن/ث |
| 06 | OpenAI: GPT-6 Luna openai/gpt-6-luna | S | ۹۰٫۱۵ بین ۸۹٫۶۱ و ۹۰٫۶۹ | ۳۵ / ۴۰ | ۵۵٫۱۵ / ۶۰ | – | ۱۵٬۲۰۰ تومان ۵٫۶ سنت | ۱۵۵ توکن/ث |
| 07 | MoonshotAI: Kimi K3 moonshotai/kimi-k3 | A | ۸۳٫۰۶موقت | ۳۶ / ۴۰ | ۴۷٫۰۶ / ۶۰ | – | ۹۱۰٬۴۰۰ تومان ۳٫۳۷ دلار | ۱۲۲ توکن/ث |
| 08 | DeepSeek V4 Pro 0813 deepseek/deepseek-v4-pro-0813 | B | ۷۹٫۸۷موقت | ۲۸ / ۴۰ | ۵۱٫۸۷ / ۶۰ | – | ۴۵٬۴۰۰ تومان ۱۶٫۸ سنت | ۱۷۶ توکن/ث |
| 09 | Qwen3.8 Max (0902) qwen/qwen3.8-max-0902 | B | ۷۷٫۷۵موقت | ۳۶ / ۴۰ | ۴۱٫۷۵ / ۶۰ | – | ۸۱۸٬۵۰۰ تومان ۳٫۰۳ دلار | ۵۴ توکن/ث |
| 10 | DeepSeek V4 Flash 0423 deepseek/deepseek-v4-flash | B | ۶۸٫۷۸ بین ۶۲٫۰۲ و ۷۶٫۴ | ۲۶ / ۴۰ | ۴۲٫۷۸ / ۶۰ | – | ۶٬۳۰۰ تومان ۲٫۳ سنت | ۱۱۲ توکن/ث |
| 11 | Anthropic: Claude Sonnet 5.5 anthropic/claude-sonnet-5.5 | C | ۶۳٫۵۵موقت | ۳۴ / ۴۰ | ۲۹٫۵۵ / ۶۰ | – | ۱٬۰۸۴٬۰۰۰ تومان ۴٫۰۲ دلار | ۲۰۲ توکن/ث |
| 12 | Z.ai: GLM 5.3 FlashX z-ai/glm-5.3-flashx | C | ۶۲٫۹موقت | ۳۴ / ۴۰ | ۲۸٫۹ / ۶۰ | – | ۱۸۶٬۰۰۰ تومان ۶۸٫۹ سنت | ۲۵۸ توکن/ث |
| 13 | Qwen3.8 Flash qwen/qwen3.8-flash | C | ۵۴٫۳۴ بین ۵۲٫۹۶ و ۵۵٫۷۱ | ۲۹ / ۴۰ | ۲۵٫۳۴ / ۶۰ | – | ۸۵٬۴۰۰ تومان ۳۱٫۶ سنت | ۷۲ توکن/ث |
قیمت تومانی با نرخ امروز: هر دلار ۲۶۹٬۹۷۰ تومان (دلار آزاد، tgju.org، ۱۴۰۵/۸/۲۸). هزینه اصلی به دلاره و با تغییر نرخ، تومانش هم خودبهخود عوض میشه.
03قهرمان هر چالش
بهترین ساخت هر چالش ویترین. روی هر کارت بزنید تا ساخته همه مدلها رو برای اون چالش ببینید.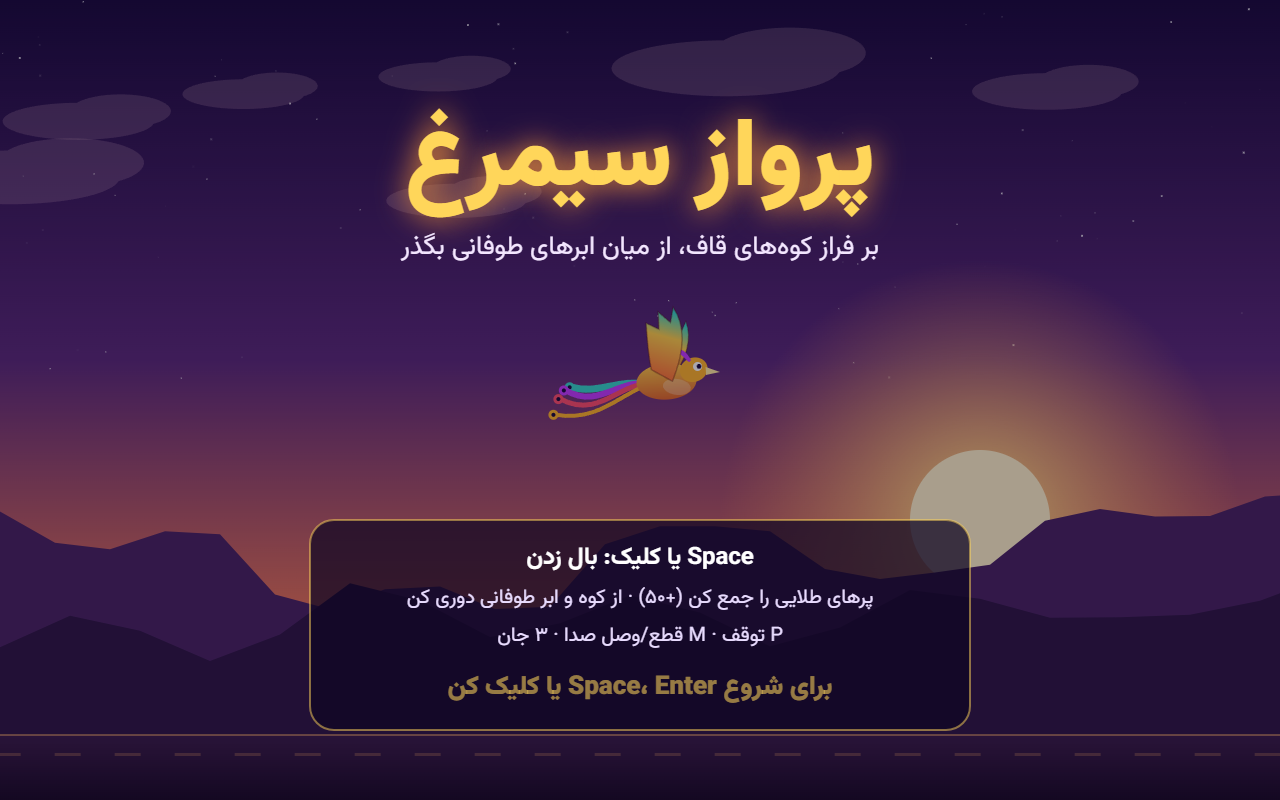 Anthropic: Claude Opus 5.5 · ۷٫۵ از ۷٫۵
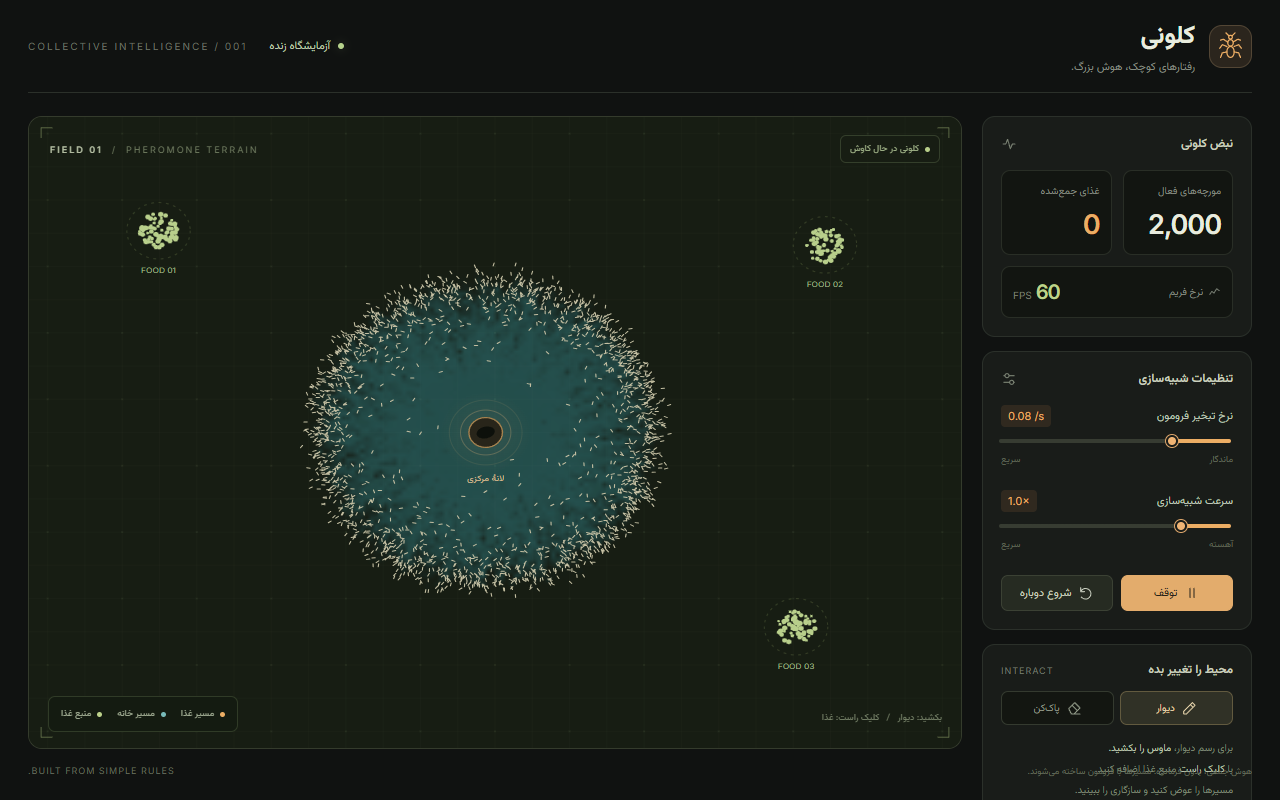 OpenAI: GPT-6.1 Sol · ۷٫۵ از ۷٫۵
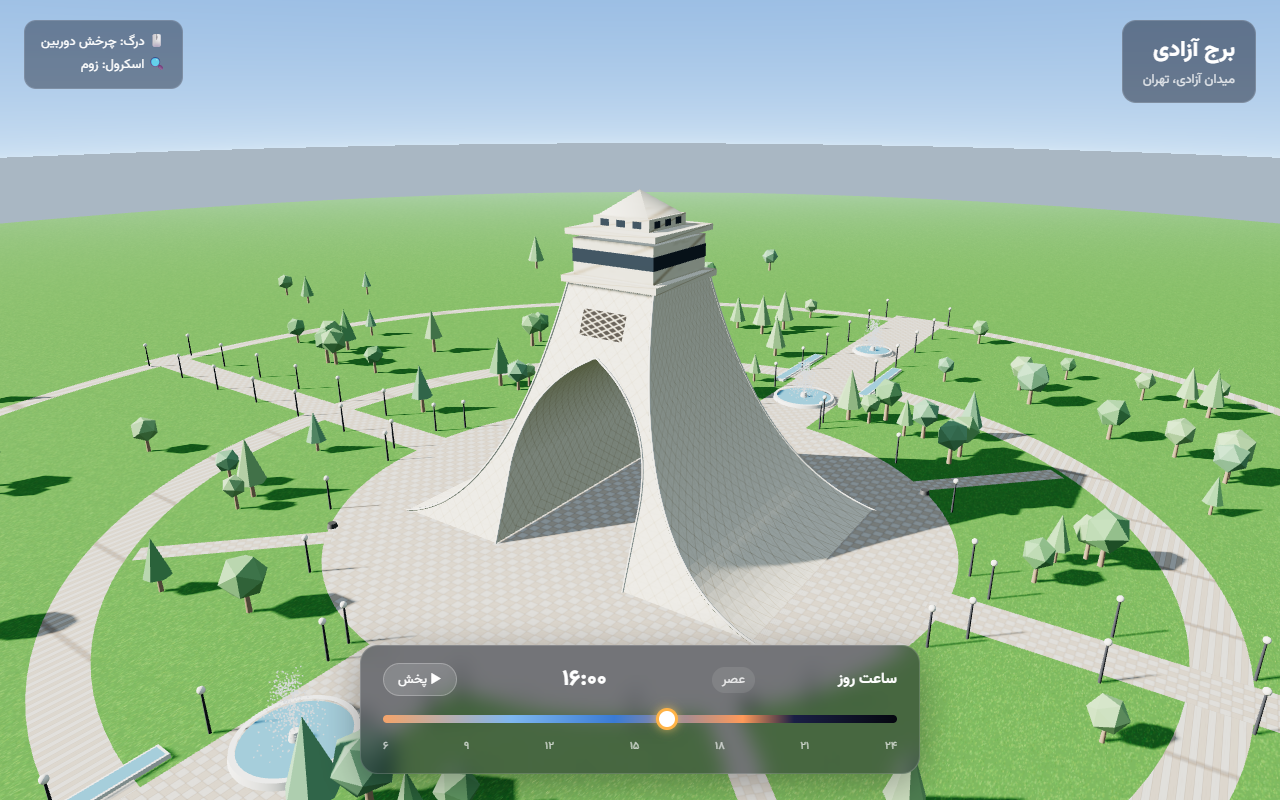 Anthropic: Claude Opus 5.5 · ۷٫۵ از ۷٫۵
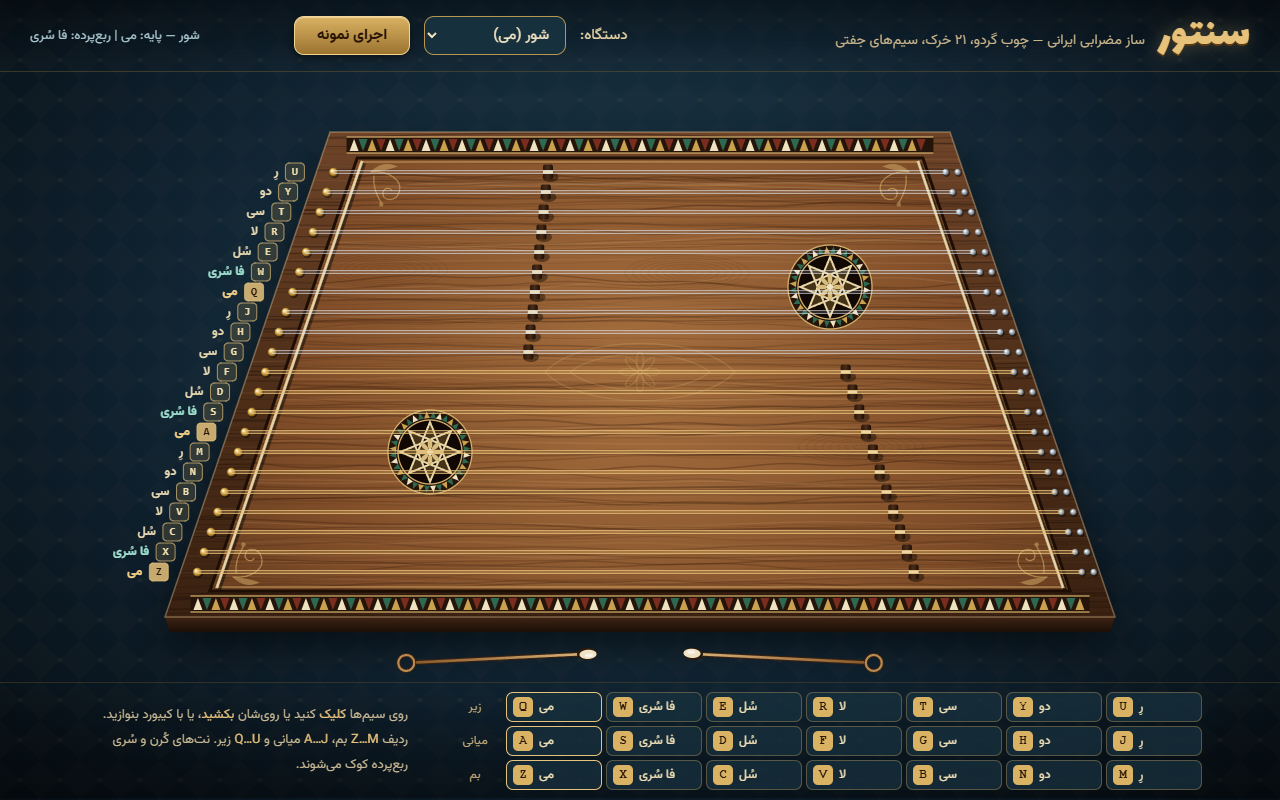 Anthropic: Claude Opus 5.5 · ۷٫۵ از ۷٫۵
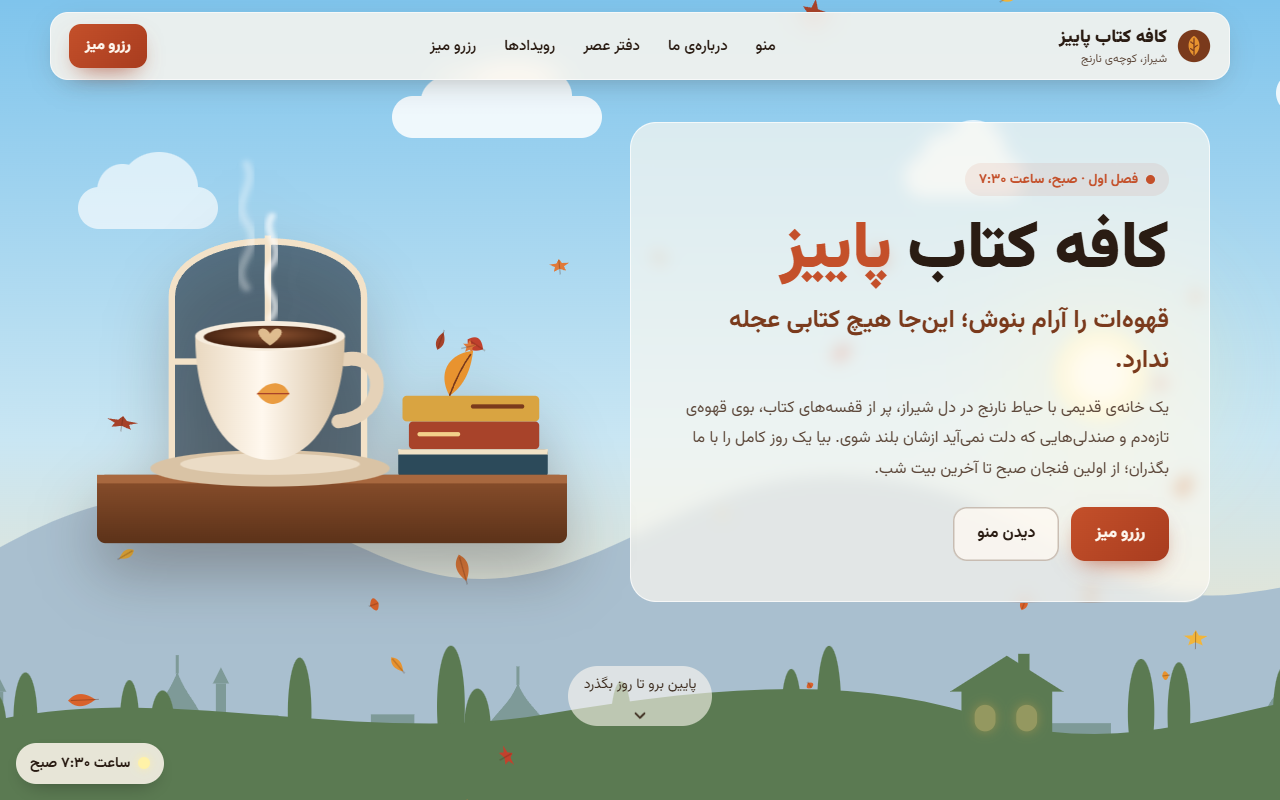 Anthropic: Claude Opus 5.5 · ۷٫۵ از ۷٫۵
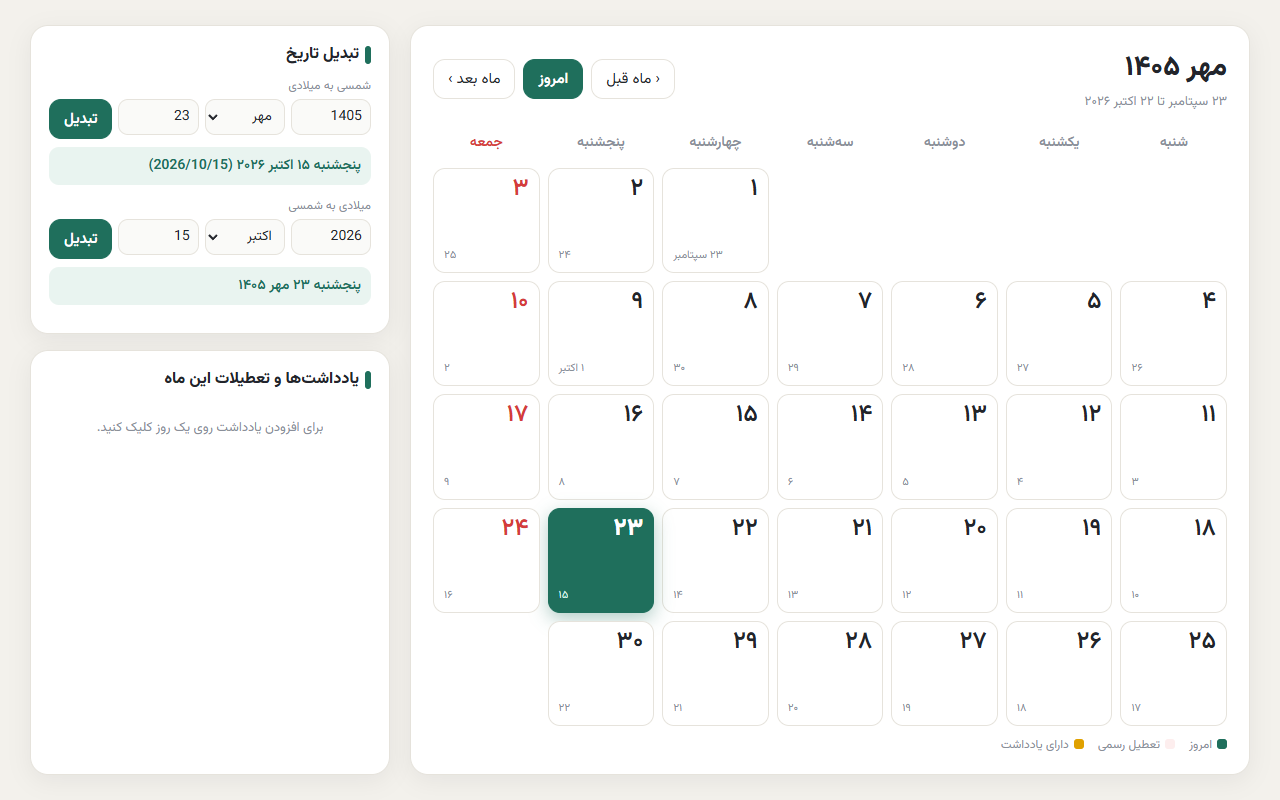 Anthropic: Claude Opus 5.5 · ۷٫۵ از ۷٫۵
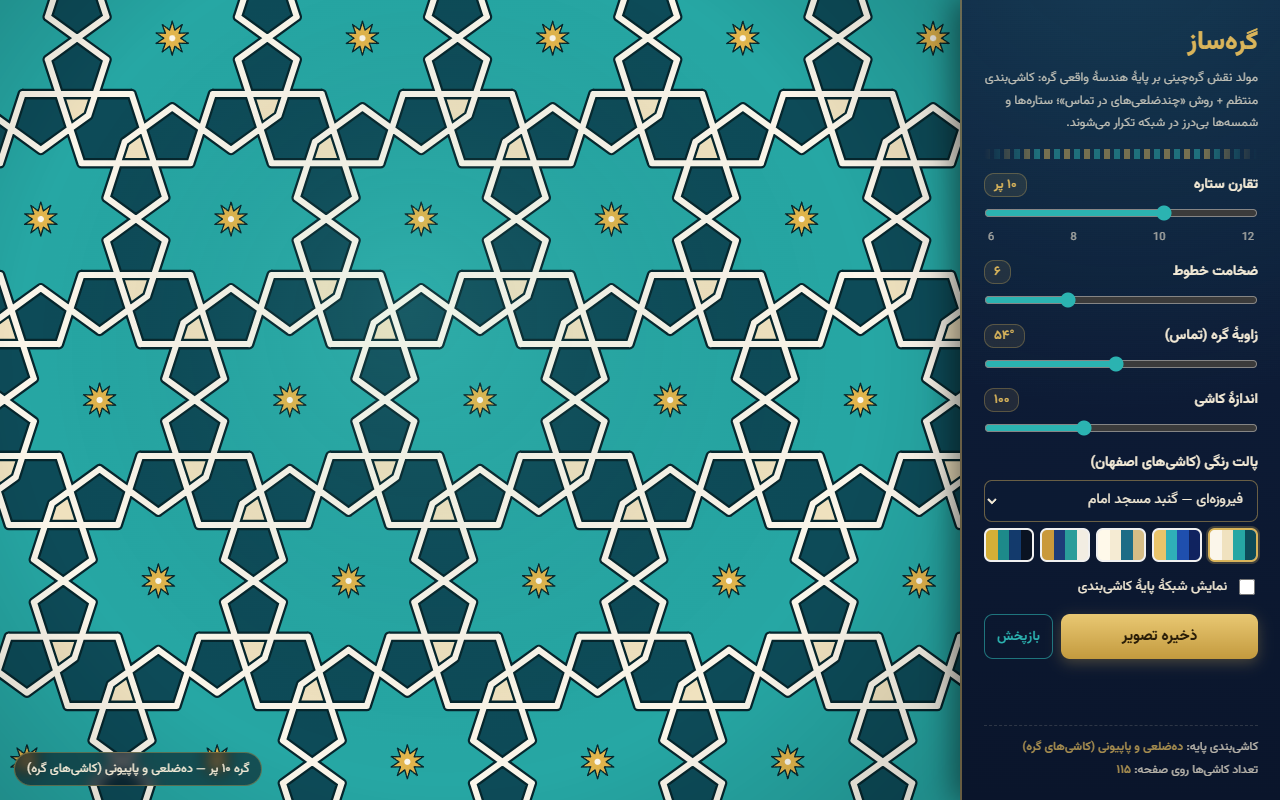 Anthropic: Claude Opus 5.5 · ۷٫۵ از ۷٫۵
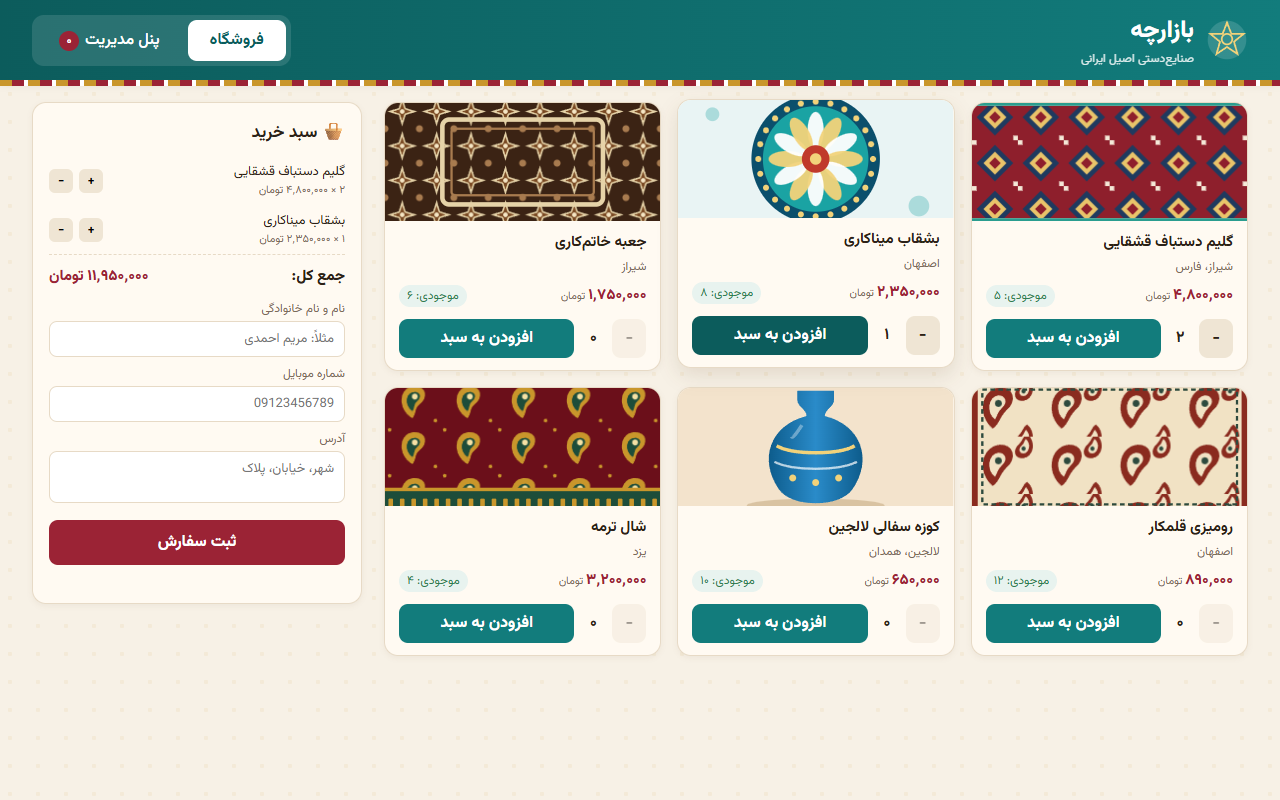 Anthropic: Claude Opus 5.5 · ۷٫۵ از ۷٫۵
04کیفیت در برابر هزینه
هر نقطه یه مدله. هرچی بالاتر و چپتر (یعنی ارزونتر)، ارزش خریدش بیشتر. هزینه همونیه که خود مدل برای جواب دادن به کل آزمون گرفت، بدون هزینه داوری. محور هزینه لگاریتمیه.
MRMP Bench چیه؟
MRMP Bench یه بنچمارک فارسی برای مقایسه مدلهای هوش مصنوعی و مدلهای زبانی بزرگ (LLM) است. از GPT و Claude تا Gemini و DeepSeek و Grok و Qwen، همهی مدلها از یه آزمون ثابت به زبان فارسی رد میشن: ۲۰ سؤال کارنامه و ۸ ساخت تعاملی.
نمره رو کد، یه مرورگر خودکار و یه هیئت داوری سهنفره از سه شرکت مختلف میدن، و جوابها و ساختههای هر مدل همینجا منتشر میشه. اینطوری خودتون میبینید کدوم مدل برای کار به فارسی بهتره، چقدر خرج داره و کجا اشتباه میکنه.
هر مدل جدید، یه قسمت جدید
نتیجه هر مدل رو توی کانال یوتیوب جلوی دوربین بررسی میکنم: ساختهها رو اجرا میکنم، با قهرمان مقایسه میکنم و نظر خودم رو میگم.